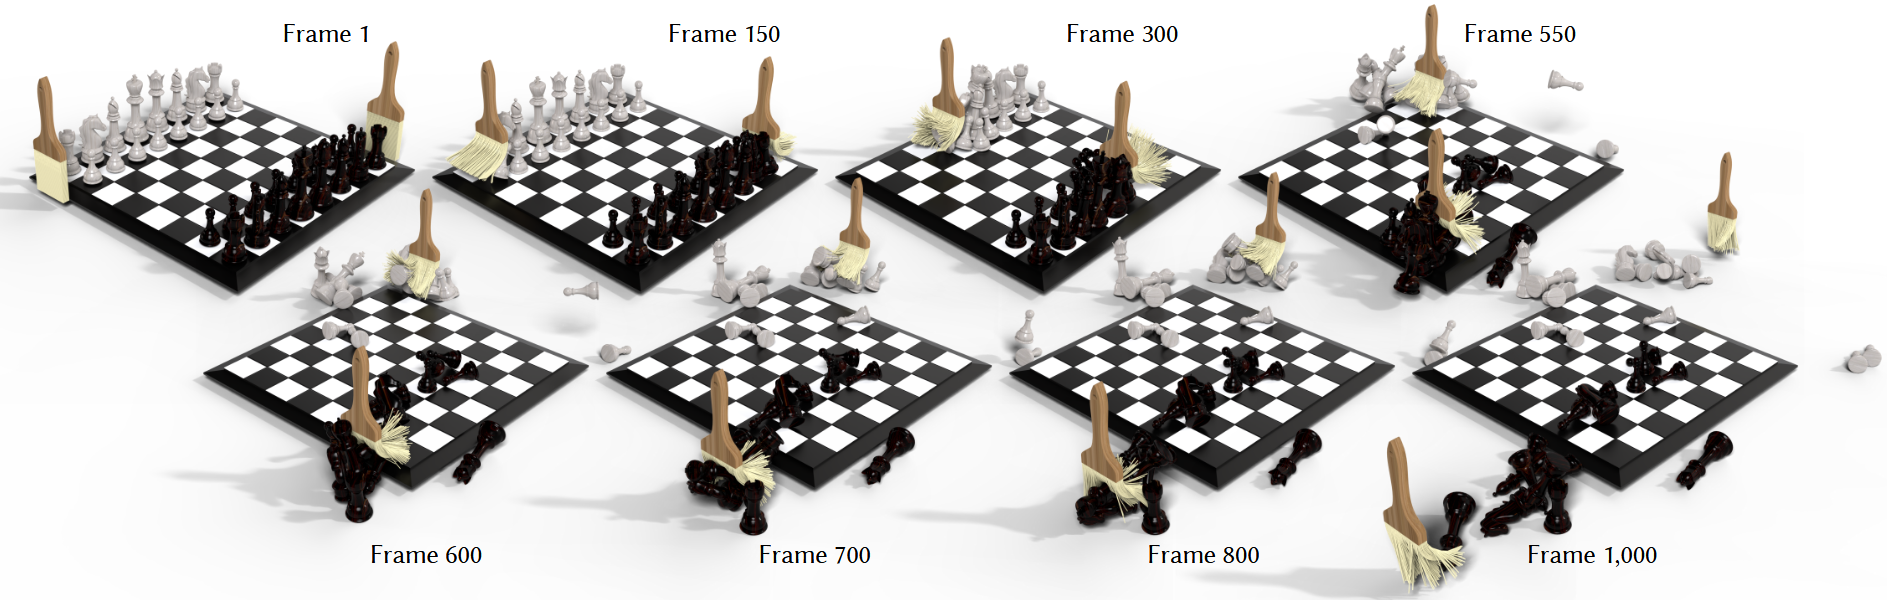
图:论文Fig.1的棋盘仿真。图中刷毛发生形变,棋子和刷柄按近刚体处理。
在上图中,刷子上的刷毛(可形变体)被棋子等硬物(近刚体)挤压,几个近刚体互相碰撞,接触点随运动不断变化……如果想在GPU上把这一切放进同一个仿真,困难往往不在于能否写出其物理方程,而在于能否足够快地解出这些方程。
Guo等人的Heterogeneous Subspace Corrections for GPU Deformable Multibody Dynamics(ACM TOG 45(4), 2026,SIGGRAPH 2026)研究的就是这个问题。论文提出HSC(异构子空间修正):把可形变体与仿射体组成的线性系统按结构拆开,在两个子空间里使用不同的近似求解方法,同时保留二者通过接触产生的耦合。
HSC通过Schur补保留耦合,用ACA压缩反复访问的接触界面,用Neumann级数近似难以直接求逆的部分,再由预条件共轭梯度法(PCG)迭代求解。
背景知识
想用计算机模拟物理过程,首先要设计若干数字来描述它。这些数字被称为自由度(degree of freedom,DOF)。例如:一个空间点的位置有 三个自由度;一个由 个可独立移动的网格顶点组成的软体,通常有 个位置自由度。自由度越多,能表达的局部变形越细,但每一步要求解的未知数也越多。
软体、有限元与刚度
可形变体通常先被切成三角形或四面体网格。有限元方法(FEM)在每个单元内部用顶点的位置插值出变形,再根据材料模型计算拉长、压缩、剪切需要多少能量。所有单元的能量相加,得到整个物体的弹性能。对顶点位置求导,得到力;再求一次导,得到局部刚度如何随位移变化。
以一维弹簧为例。两个端点相距 ,自然长度是 ,弹性能为
这里 是弹簧刚度: 越大,偏离自然长度时能量增长越快。三维弹性体比弹簧复杂得多,但”形变产生能量,能量一阶导数为力,二阶导数反映刚度“这条关系没有变。论文同时放入软材料和高刚度材料,相当于让一组方程同时面对软弹簧与极硬弹簧。
理想刚体则不允许形状改变,只允许整体平移和旋转。用三个平移量和某种旋转参数,可以只用少数自由度表示整个物体。此处的难点在于旋转不是普通向量,随意给旋转矩阵各元素加增量会破坏矩阵的正交性。论文使用的仿射体动力学(Affine Body Dynamics,ABD)取一个折中:用
把静止形状中的点 映射到当前位置 。 有9个数,平移 有3个数,一共12个自由度。如果 是旋转矩阵,形状保持刚性;如果它略偏离旋转矩阵,物体就有少量仿射变形。算法用刚性惩罚控制这种偏离。因此,仿射体在本文中应理解为被约束得接近刚体的低自由度模型,而不是完全不会变形的理想刚体。
时间推进被转化为最小化问题
计算机中的模拟大多是逐时间步进行的:已知第 步的位置和速度,求第 步。显式方法根据当前受力直接预测下一步,容易理解,但很硬的系统往往要求极小时间步。论文使用隐式时间积分:下一步的位置同时出现在力与能量中,因此需要解一个优化问题。
论文§3.1将每一步写成
和 是两类物体(可形变体和仿射体)的弹性能, 惩罚偏离按原速度自由运动所预测的位置, 是防止物体穿透的接触能量。可以把优化想成在寻找一个折中位置:尽量保持运动惯性,同时不能任意拉坏物体,也不能让相碰的表面穿透。
时间步长 会影响数值求解的难度。惯性项的曲率含有 :较小的 往往使这部分对Hessian的约束更强;较大的 可以用更少步推进同样的物理时间,但每一步可能更难解,动态细节也可能被数值阻尼抹去。论文实验里的“秒/步”指计算一个仿真时间步的墙钟时间,不是实时运行速度。
牛顿法、梯度和Hessian
令所有未知数合成一个向量 ,总能量为 。梯度 告诉我们局部能量增长最快的方向;负梯度指向下降方向。Hessian 进一步描述不同方向的曲率。牛顿法用当前点附近的二次近似求一个增量:
上式右边是线性方程组。所以一次时间步中有两层求解:外层牛顿法反复更新非线性的物体位置,内层线性求解器在每个牛顿步计算 。论文实验中牛顿迭代次数、CG迭代次数、每步耗时是三种不同指标,不能互换。
由于二次近似只在当前位置附近可靠,程序不能无条件采用完整的 。论文使用CCD(连续碰撞检测)限制初始步长,避免更新轨迹中途发生穿透;再用回溯线搜索缩小步长,直到总能量下降。线性求解器再快,也仍需这些外层机制保证仿真推进。
接触对方程的影响
IPC(Incremental Potential Contact,增量势接触)用障碍势表达“不穿透”:物体距离安全时没有或几乎没有惩罚;距离接近零时,能量急剧升高。它像一堵随距离变近而越来越陡的墙,阻止求解器走到穿透状态。
但“陡”意味着障碍势的二阶导数可能非常大,也就是Hessian在某些接触方向上变得极硬。一个场景中的接触点还会随着帧和牛顿迭代出现、消失、移动,矩阵的非零结构也跟着变化。因而接触既增加数值难度,又增加GPU上数据组织的难度。刷毛触碰棋子的界面就是论文要反复处理的软体—仿射体接触。
条件数、CG与预条件
先想象二维能量曲面。两个方向的曲率相近时,曲面像圆碗;一个方向很陡、另一个方向很平时,曲面像又深又窄的长谷。在线性方程的对称正定矩阵中,最大与最小特征值可表示这两个极端曲率,条件数为
例如 的条件数就是一百万。这意味着迭代法可能很难同时消除两个方向的误差。CG每次依据当前残差生成新的搜索方向,只需反复计算 ,不必像Cholesky那样做全局分解;但在很差的谱分布下,CG需要更多轮。论文在组装前将局部Hessian投影为半正定,再结合惯性等项求解,这也是使用CG类方法所需的数值处理的一部分。
预条件可以理解为先把“长谷”适当拉圆,再让CG搜索。实际做法是构造一个容易应用、但接近 的算子 。它无须精确求逆;只要降低迭代所见系统的难度,额外花的预处理时间就可能由更少的CG步数补回。HSC的Neumann级数正承担这种工作。
CG是否求解完成通常通过残差判断:若当前猜测是 ,残差就是 ;残差越小,说明代回方程后差得越少。PCG即“带预条件的CG”,其使用近似逆帮助CG找到更有效的搜索方向。论文采用 的PCG容差,意味着内层线性问题求到足够支持外层牛顿推进即可,并不要求每轮都得到机器精度的解。
GPU偏爱某些线代操作
软体网格中,每个顶点主要与附近单元相连,所以Hessian大多为零,适合用稀疏矩阵存储。稀疏矩阵向量乘(SpMV)只访问非零项,可以并行分配给大量GPU线程。不过可以并行不等于没有成本:接触生成的稀疏位置不规则,线程需要读不同位置,访存和负载都可能不均匀。
直接法要对大稀疏矩阵做分解,分解过程还会产生原来没有的非零项,称为填充;这会增加内存和计算量。迭代法避免了这一步,但又受条件数影响。HSC的设计正是在这两种成本之间找出路:让需要重复做的矩阵向量操作保持GPU友好,同时减少病态带来的迭代次数。
至此,HSC的核心问题可以说得更具体:一个牛顿步里,如何便宜地反复计算软体、仿射体和接触共同构成的线性系统,并让CG尽快收敛?
整帧求解流程列表如下:
- 根据当前物体位置找到可能接触的几何元素,并计算弹性、惯性与接触能量。
- 求梯度及局部Hessian,形成牛顿步需要的分块线性系统。
- 用HSC求这个线性系统的近似解:Schur补组织两个子空间,ACA处理耦合,Neumann级数提供近似逆与预条件。
- 由CCD与线搜索确定可接受的步长,更新位置;如果还未收敛,继续下一轮牛顿迭代。
软体与近刚体一起求解为何困难?
隐式时间积分将下一时刻的位置写成能量最小化问题。论文§3.1中的能量由软体弹性、仿射体弹性、惯性以及IPC接触障碍势组成。牛顿法每次更新都要解一个线性系统:
其中 是可形变体网格顶点的自由度, 是仿射体的自由度。仿射体用一个 线性变换加三维平移描述运动,即每个物体有12个自由度;相较于逐顶点描述一个很硬的弹性体,这使未知量少得多,也允许物体略微偏离完全刚性。
麻烦在于系统的条件数。很硬的材料、接近碰撞时迅速变陡的IPC障碍势,会带来很大的曲率;柔软的变形模态则可能有很小的曲率。两端相差越大,共轭梯度法(CG)通常越难收敛。GPU擅长并行的矩阵向量乘,但如果每个牛顿步要做大量CG迭代,这一优势也会被迭代次数吃掉。这里的“慢”主要是为了达到精度而需要更多次迭代,并非病态本身让一次矩阵向量乘变慢。
直接分解矩阵可以减轻迭代收敛问题,却要付出矩阵组装、分解及存储开销。HSC想保留迭代求解器对大规模GPU计算的适应性,同时处理强接触和材料刚度差异。
从能量式到分块矩阵
论文Eq.(1)把下一时刻的软体位置 和仿射坐标 一起作为优化变量。将所有未知量拼为 ,总Hessian自然按变量分块:
这三个块的来源不同: 包括软体惯性、弹性及其接触响应; 包括仿射体惯性、刚性惩罚、关节及其接触响应; 则是混合接触能量对两类自由度的交叉二阶导数。如果没有软体与仿射体之间的相互作用, 就为零。论文的算法抓住了这一物理分工,而不是在一个巨大的矩阵上套同一种预条件器。
一:使用Schur补在保留耦合的前提下拆开系统
按软体和仿射体的自由度排列,论文的Hessian有清晰的分块结构:
处理软体, 处理仿射体, 处理两者之间的接触。由第二行消去 ,就得到只关于软体增量的系统:
把上面的矩阵乘法按行展开,更能看清消元过程:
第二行给出 。将它代入第一行,整理后就是论文Eq.(3a):
这里的 是Schur补。它的作用可以这样理解:软体施加的变化先经 传给仿射体;仿射体按自身的响应 产生位移;这个反作用再经 传回软体。因此,消元并不是忽略硬物,而是把硬物的影响折算进软体方程。求出 后,再回代得到 。
如果矩阵消元看起来抽象,可以把两侧各缩成一个未知数。设软体方向刚度为 ,仿射体方向刚度为 ,耦合强度为 ,则系统矩阵为 。由第二行解出仿射增量再代回第一行,软体实际面对的刚度就变成 。其中 正是“仿射体会跟着退让”对软体产生的修正。假如直接丢弃 ,相当于假装两个物体从未接触;Schur补没有这样做。
还有一个容易误解的点:式中的 只是数学记法。实现时不需要真的生成一个稠密逆矩阵;给定向量 ,求解 就得到了 的作用。HSC 后面近似的也是这个算子作用。
此处还需要两个条件。首先, 必须足够稳定,才能完成仿射侧求解。其次,如果整体 对称正定且 正定,那么Schur 补 也正定,才适合用CG类方法。实际仿真的局部Hessian未必天然满足这一点;论文§3.1在组装前对四面体与接触单元的Hessian做半正定投影,以获得可用于求解的矩阵。因而“做 Schur 补就一定容易解”不是定理:它只是把两类数值性质不同的未知量分开,让后续方法有机会针对性处理。
代价也很明显。每次计算 都要完成
如果CG做几十次迭代,接触界面的乘法和对 的求解也要重复几十次。论文后面的ACA与Neumann近似,分别瞄准了这两个成本。
二:使用ACA压缩反复计算的接触界面
矩阵 可以很大,但真正发生软体—仿射体接触的自由度只占一部分。论文§3.2指出,其秩受两侧参与接触的自由度数 限制:
这里需要区分稀疏与低秩。稀疏指大多数元素是零;低秩指很多行或列包含重复的信息。例如两个物体只通过少数几种整体运动模式相互影响时,即使界面上有许多接触点,它们传递的信息也可能主要集中在少数独立方向。一个矩阵完全可能既稀疏又近似低秩,但这两个性质并不互相推出。
低秩表示 的意思是:先用 把高维软体向量压到 个系数,再由 将它送到仿射侧。若 ,则 、,而 远小于 。可把它看成“接触影响只需经过 条通道”。这是读懂ACA对Schur补有何帮助的关键。
将这一表示放回Schur补:
右边不是一个需要显式存储的 稠密矩阵。对向量 作用时,可以依次计算 、中间的 维运算、再乘 。若仿射侧求逆也只提供近似,就把式中的 理解为相应近似算子的作用。这个改写说明ACA与Neumann级数不是两个孤立技巧:前者缩小“往返耦合”的通道,后者降低通道中仿射侧响应的成本。
作者使用自适应交叉逼近(Adaptive Cross Approximation,ACA)构造这两个因子。算法从尚未表示的残差中挑选一个显著元素,取出对应行和列形成一个秩一项,再从残差中减去;如此重复,直到达到预设秩。直观上,它优先抓住接触矩阵里影响大的部分。具体地,若当前残差为 ,选中的元素是 ,便取 、,更新 。这一项会让选中行和选中列在新残差中归零。重复挑选,便得到若干个秩一项之和。
例如取一个小矩阵 。先选最大元素 ,对应列为 ,对应行除以 后为 ;两者的外积正好表示前两行的相关部分。余下的非零元素只有右下角的 ,再用一个秩一项即可表示。真实接触矩阵不会这样整齐,因此ACA通常在预设秩处停止,允许保留残差。论文算法1将上限写成 ;实际计算能否在较小秩处获得收益,还要由误差和计时共同判断。
论文进一步利用这一过程弱化较软接触在当前线性系统中的权重,将相关误差交由后续牛顿迭代处理。这是对线性求解的近似,不等于从总接触能量中删除这些接触。ACA的近似质量仍依赖实际矩阵与所选秩,不能仅凭低秩直觉保证。
需要注意:原矩阵本来就是稀疏的,低秩形式不保证比原稀疏矩阵更省内存,也不意味着一次乘法在任何规模下都更便宜。论文要优化的是GPU上多次应用耦合算子时的不规则访存与重复工作。使用低秩因子后,中间计算可以转成更规则的乘法,同时减少需要显式处理的界面信息。
ACA在GPU上还有一个实现难点:每次秩一更新都会改变残差矩阵的非零分布。补充材料§1用坐标—数值对(COO)记录更新,经 sort_by_key 排序,再用 reduce_by_key 合并同一坐标,避免按稠密矩阵遍历大量零元素。这也说明:低秩近似本身只是数学形式,能否加速还取决于更新过程如何映射到GPU。
三:使用Neumann级数近似逆并帮助CG收敛
若仿射体彼此不接触, 接近由各物体组成的块对角矩阵,局部求解相对容易。仿射体互相碰撞后,非对角耦合出现,反复使用 就不再轻松。
先回想普通等比级数:当 时,。矩阵版把数字 换成矩阵 ;只要其谱半径小于1,就有 。取前几项就是一个可计算的近似逆。这里的谱半径指特征值绝对值的最大值;如果它不小于1,继续加项并不保证会逼近真逆。
论文§3.3将系统矩阵写成块对角部分减去耦合部分,并用截断Neumann级数近似逆:
设 是容易逐块处理的部分, 是剩余耦合,则
这一步就是把前述矩阵等比级数代入。注意矩阵乘法一般不能交换顺序, 位于每一项的右侧。论文不求无限项,而是使用带松弛的有限项版本:
是保留的项数, 是松弛参数。可以把第一项看作只考虑局部块,后续项逐步补入块与块之间的影响。级数收敛需要相应迭代矩阵的谱半径小于1;作者在实验中使用 ,并观察到至多五阶的近似已能取得较好效果。这是论文测试场景中的经验结果,不能推成任意系统都只需要五阶。
为何多出一个 ?在简化记法下,迭代矩阵可写成 。松弛参数改变了其特征值位置,有机会让最大绝对值降到1以下。它不是可以随意套用的“加速倍率”;数值是否稳定,仍要看具体系统的谱。论文报告 的普通Jacobi分裂在困难场景中可能收敛很差,而 在其测试中有效。
把 代回近似逆,可得到更直观的等价式与误差关系:
第二个等号由等比和逐项抵消得来:。它说明只用 项直接近似求解时,剩余误差由 控制;若 ,阶数增大一般会改善近似,但每增加一阶就多做一次相关矩阵向量运算。这里把 一直保留在式中,也避免把论文后续为方便说明而采用的 简写误当成实际参数。
同一近似有两种用途:在Schur补计算中近似仿射子系统的求逆;在PCG中作为预条件器,改善迭代遇到的谱分布。预条件器不必给出精确解,只要使随后CG的迭代更有效即可。这也是“少做几次局部修正,却让整体收敛更快”的关键。
更具体地说,在 出现的地方,可以把短级数作为仿射子系统的近似求解;对可形变侧 ,论文构造同类近似作为PCG的预条件器,而跨子空间的响应仍由低秩 进入Schur补。若把短级数单独当作最终求解器,精度受固定阶数限制;把它放进PCG,每轮之后还能依据新残差继续修正。论文§5.3.2的可形变恐龙消融中,、、对应约7.2、6.0、3.7秒/步。阶数更高使单轮更贵,却可能通过减少整体迭代使总时间下降;超过五阶后,论文观察到收益递减。
将上面三个组件放在一次牛顿线性求解中
用 表示对 的短级数近似,用 表示可形变侧的预条件算子,令 。一次线性求解可按以下顺序理解:
- 构造软体侧右端 。
- 用PCG求近似Schur系统 ,其中 ;每轮用 帮助PCG修正残差。
- 得到软体增量后,回代 。
接触矩阵的组装方式
前文一直使用 、 这样的数学表示,但程序需要先把接触的贡献送进对应矩阵位置。以软体的一个顶点碰到仿射体的一个三角形面为例:软体顶点有3个自由度,整个仿射体有12个自由度,因此这一处接触所依赖的独立未知数最多是15个。接触能量先按碰撞顶点的位置计算,再通过链式法则映射回这15个未知数。
令 表示这一处接触涉及的软体顶点与仿射自由度, 表示顶点和三角形三个角点的位置。若 ,则补充材料§2的链式法则是
通常复合函数的二阶导还可能包含 自身的二阶导;这里顶点位置对仿射自由度是线性的,所以这一项为零。上式把顶点空间中的接触曲率映射到求解器真正使用的自由度空间。其非对角块就进入 ,仿射—仿射的接触贡献进入 。
这里的雅可比矩阵只是“输出位置如何随输入自由度改变”的表。仿射体顶点满足 ,所以它对仿射自由度的雅可比是一个 的小矩阵,只依赖静止位置 ,不随当前运动状态变化。补充材料§2利用这一常数结构,预先组织不同接触类型的非零模式,组装障碍势的梯度与Hessian时可查表取块,减少重复的小矩阵乘法。
若将 的三行依次排列,,这个小雅可比可直接写成
可见,矩阵中大量位置固定为零,其余值只与静止顶点坐标有关。这解释了为什么论文不必对每个接触重新做一遍普通稠密矩阵乘法。
存储时也没有必要建立一个总自由度 × 总自由度的稠密矩阵。软体—软体、软体—仿射体、仿射体—仿射体分别产生不同大小的块;只保存发生相互作用的位置。GPU并行线程计算许多接触时,若直接同时往同一矩阵坐标写入,可能产生写冲突。论文的COO坐标记录、排序与归约,正是把分散写入整理成可并行处理的数据流。
重新设计旋转约束
求解虽然被加速,关节和旋转仍可能带来困难。显式使用欧拉角、四元数或旋转矩阵,各有奇异点、归一化或复杂求导的问题。论文§4选择从单位转轴 与转角 构造旋转,使用的Rodrigues公式是其Eq.(10):
是一个反对称矩阵,用矩阵乘法表示叉乘。直接让 随优化变量一起变化,会把三角函数带进梯度与Hessian;作者采用滞后更新相对转角的方式处理该问题。论文Eq.(11)将两个仿射体的相对旋转写成Frobenius范数下的惩罚项,并称之为二次旋转约束。
为了理解“二次”的计算好处,可以先看一个示意性的固定系数约束。若当前牛顿步里的几何系数已固定,约束残差为 ,则
梯度是线性的,Hessian只需由固定系数形成,不必在每次迭代中对SVD或三角函数做复杂求导。这个式子说明二次最小二乘的数值动机;论文原式还包含转轴的更新,不能简单把 当成全程不变的常数。
二次形式的梯度和Hessian更易计算,也更适合与前面的线性求解框架配合。不过,仿射体只是在惩罚作用下接近刚体,并非数学上始终严格属于旋转群。补充材料§4为此加入自适应刚度:以 衡量刚性偏离;超过 时,将对应刚度乘以 ,上限设为 。这一设计帮助论文中的高速车轮和关节场景抑制逐帧累积的形变。
论文还给出转轴更新 ,但在高刚度ABD物体接近旋转矩阵时,以 省去归一化。这个近似依赖“物体已经足够接近刚性”的前提;若 明显拉伸,轴的长度就会偏离1。自适应刚度策略与这里的近似因此是相互关联的。
这是一个重要的取舍:仿射表示便于保持连续碰撞检测(CCD)所用的线性顶点轨迹,但严格刚性需要额外处理。HSC通过约束形式和自适应惩罚控制误差,让仿射体尽量接近完全刚体。
实验数据
论文§5的实验使用RTX 4090(24GB),碰撞检测与数值优化都在GPU上执行,PCG容差设为 。
实验主要关注下面三个指标:迭代次数反映需要多少轮更新;每次迭代成本反映一轮要做多少计算、读写多少数据;总耗时受两者共同影响。ACA主要改变耦合计算的成本,Neumann预条件主要影响求解的收敛,也会增加单轮工作。
| 测试 | 论文结果 | 结论 |
|---|---|---|
| Chainnet与Armadillo,ACA消融(§5.3.1) | 每步约66.6秒 vs 97秒;迭代数57 vs 49(有ACA vs 无ACA) | ACA减少求解耗时 |
| Chessboard第550帧,超过120万个软体—仿射体接触(§5.3.1) | 达到目标残差约40 秒 vs 63 秒;50 vs 41次迭代 | 接触密集时,每次迭代的成本差异可以主导总时间 |
| Roller,Neumann预条件消融(§5.3.2) | 8.0秒 vs 21.1秒,21.8 vs 55.6次迭代 | 预条件在该场景同时减少了迭代次数和时间 |
| Chessboard与Stiff-GIPC,对照第300帧(§5.4) | 11.2秒 vs 29.1秒,9 vs 22次迭代 | 在这组特定场景与配置下,HSC的求解更快 |
从消融中区分两个组件的贡献
ACA的两组消融最有意思:使用ACA后,报告的迭代数并没有减少,甚至略多,但达到目标残差的时间缩短了。这支持“压缩接触界面降低单次求解工作量”的解释。如果只看迭代数,反而会误判ACA无效。论文也比较了直接保留完整界面的版本和更弱的无ACA基线;两种基线定义并不完全相同,因此不同加速倍数不应混成一个数字。
Roller测试则隔离了预条件器的作用:它只包含摩擦接触下的可形变体,因而不能把加速解释成软体—仿射体的低秩耦合。Neumann预条件使报告的迭代数从55.6降到21.8,同时降低总耗时,说明改善求解谱分布这条路线单独就有价值。论文还让阶数 从1增至5:阶数过低时便宜但不够有效,阶数过高时每轮额外运算开始抵消收敛收益。
大场景数字如何理解
论文Table 1的Chessboard场景有约30.4万顶点、平均76.7万接触,峰值约660万接触,平均每步18.2次牛顿迭代、24.3秒。这些数字展示了方法对密集接触的承受能力,也说明它并非实时仿真。第550帧的“约40秒 vs 63秒”是另一项针对ACA的指定帧测试,不能与Table 1的全程平均“24.3秒/步”直接相减。
论文还通过改变参数测试敏感性:Armadillo场景的密度 从10到1000时,Table 1中的迭代数分别为61.4、57.0、68.2;轮胎材料从10MPa增至100MPa时,容器与轮胎场景的平均耗时由85.5秒变为97秒。这些结果说明所测范围内没有出现随参数量级急剧恶化的运行时间,但不能由两三组离散测试推断任意密度、刚度下都稳定。
还有一个值得注意的对照:扭曲环面测试中,直接Cholesky分解提供更精确的线性解,牛顿收敛比HSC更快;但在论文的测试中,分解开销使其总时间不占优。因此,“与直接法相当的收敛表现”和“总运行时间更短”是两件应分别检验的事。论文也给出对CPU直接法Newton-barrier的大幅加速结果,但CPU与GPU的硬件差异同样包含在这一对比里,不能把全部倍数归因于HSC的算法设计。
这些结果说明HSC对论文覆盖的高刚度、密集接触场景有效;它们没有证明所有混合多体场景都能得到相同比例的提升。尤其是消融表里“迭代次数”和“单次迭代开销”会朝不同方向变化,评价一个方法必须看完整求解时间。
论文的边界与相关理解
作者在§6明确指出:目前框架不支持逆动力学;模型范围集中在可形变体与仿射体,尚未覆盖无网格或粒子离散;与真实物理实验的对照仍有待完成。补充材料则表明,GPU上的接触组装、稀疏残差更新和自适应刚度也是方法能否落地的重要组成部分。
总而言之,HSC**先依据物理自由度划分系统,再针对每块的数值结构选择便宜而有效的近似,把省下的计算留给必要的全局迭代。**Schur补负责保留跨物体影响,ACA负责压缩接触界面,Neumann级数负责构造近似逆和预条件器,旋转约束与刚度控制则让仿射物体在复杂关节场景里可用。
原文:Dewen Guo等,Heterogeneous Subspace Corrections for GPU Deformable Multibody Dynamics,ACM Transactions on Graphics 45(4), Article 100, 2026。DOI: 10.1145/3811275。